الخلاصة السريعة
- يتنبأ التعرّف على الكلام بالنص الأرجح لكل مقطع صوتي، ولا يستخرج نصاً مخفياً داخل التسجيل.
- وسّع التدريب على ساعات ضخمة متعددة اللغات نطاق العمل، لكنه لا يَعِد بجودة متساوية في كل لغة.
- تمييز المتحدثين والتوقيت والترقيم والتصدير مكونات منفصلة حول محرك التعرّف، ويخفق كل منها وحده.
- يحدد الميكروفون والغرفة النتيجة أكثر من اسم النموذج في معظم التسجيلات.
- نحتفظ بالصوت والنص الموقوت والتصحيح البشري في مكان واحد، لأن الأخطاء تظهر عند المقارنة بينها.
1. ما يصل إلى البرنامج إشارة لا جملة
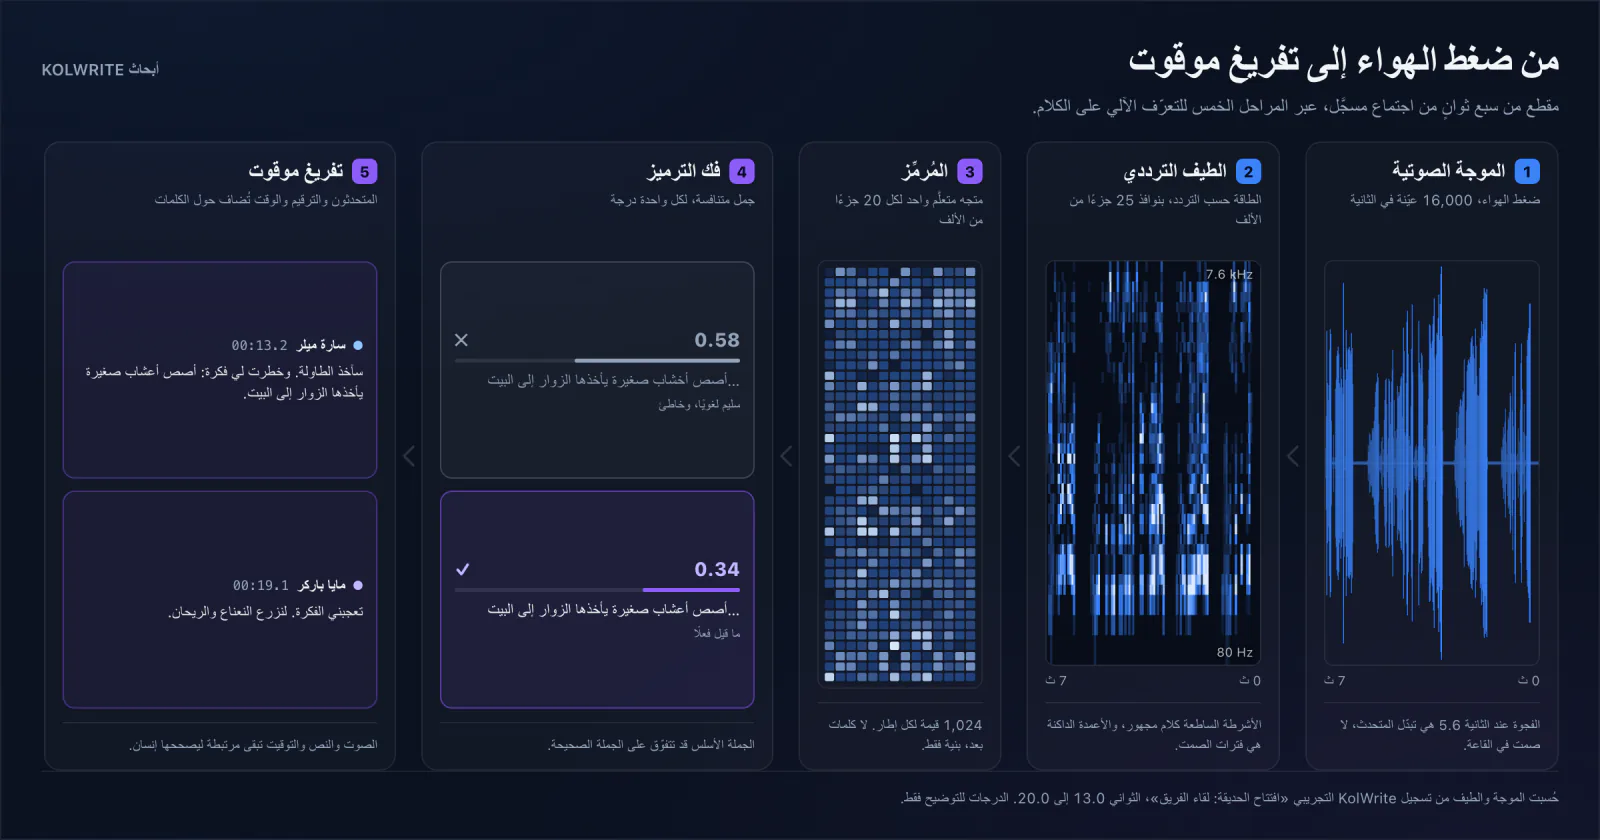
يصل التسجيل إلى البرنامج كسلسلة طويلة من الأرقام، ويمثل كل رقم ضغط الهواء في لحظة واحدة. وقبل اقتراح أي كلمة يُقسَّم الصوت إلى نوافذ قصيرة، وتوصف في كل نافذة طاقة الصوت عبر الترددات. تتعلم النماذج الحديثة جزءاً كبيراً من هذا الوصف بنفسها. ولا تتغير الفيزياء. صوتان متداخلان وصدى الغرفة ومروحة الحاسوب وضغط الملف تصل كلها داخل إشارة واحدة.
لذلك يؤثر الميكروفون أكثر مما يتوقع كثيرون. الميكروفون القريب من الفم يحفظ الحروف الساكنة والفواصل الصغيرة بين الكلمات. والهاتف الموضوع وسط طاولة اجتماع يجمع الصدى والجميع دفعة واحدة. لم نرَ نموذجاً لغوياً يعيد حرفاً ابتلعته الغرفة.
2. المُرمِّز يبني خريطة للكلام
يحوّل المُرمِّز مقاطع الصوت القصيرة إلى متجهات تحمل ما يفيد التنبؤ: تفاصيل صوتية، وإيقاعاً، وتمييزاً جزئياً بين الكلام والضجيج والصمت. وقد غيّر التدريب المسبق الواسع هذه المرحلة. أعلنت ورقة بحثية من عام 2022 تدريباً على 680 ألف ساعة من الصوت متعدد اللغات بإشراف ضعيف. ووسّعت أعمال لاحقة التغطية إلى أكثر من مئة لغة، ثم إلى أكثر من ألف، معتمدة على تسجيلات لم يفرّغها أحد.123
يشتري الحجم خبرة لا مساواة. فالنموذج الذي قابل ميكروفونات ولهجات وموضوعات أكثر يفاجئه تسجيلك بدرجة أقل. وقائمة اللغات تقول إن النص سيعود بتلك اللغة. ولا تقول كيف يتعامل النظام مع مكالمة مبيعات بالعبرية، أو مقابلة بالعربية الفلسطينية، أو جملة تبدأ بلغة وتنتهي بأخرى.
3. فك الترميز منافسة بين جمل محتملة
لا يختار النظام كلمة واحدة في كل خطوة. بل يمنح تسلسلات كاملة درجات أمام الصوت وأمام ما تعلّمه عن بناء الجمل. لذلك يفضّل عبارة مترابطة على سلسلة أصوات متشابهة. وللسبب نفسه قد يعيد جملة سليمة لم ينطقها أحد حين يكون الصوت غامضاً.
تظهر هذه المفاضلة في الأسماء والأرقام والتنقل بين اللغات. تكرر أبحاث الكلام المختلط الملاحظة نفسها: بيانات وفيرة لكل لغة منفردة، وقليلة جداً حين يبدّل المتحدث لغته داخل الجملة. وتضيف العبرية والعربية صعوبات خاصة، منها تعدد الإملاء وقلة الكلام العفوي المسجل. توسّع مجموعات البيانات البحثية الحديثة هذا الرصيد. وهي لا تغلق الفجوة.456
4. النص النهائي سلسلة مراحل لا إجابة واحدة
ينتج محرك التعرّف كلمات وأزمنة. ويجيب تمييز المتحدثين عن سؤال آخر: من تكلم ومتى. وتعيد المحاذاة كل كلمة إلى الساعة. ويجعل الترقيم وتقسيم الفقرات النص مقروءاً. ثم يأتي التخزين وإعادة المحاولة والتحرير والبحث والتصدير. كل مرحلة مكوّن قائم بذاته، وكل مكوّن قد يخفق وحده.
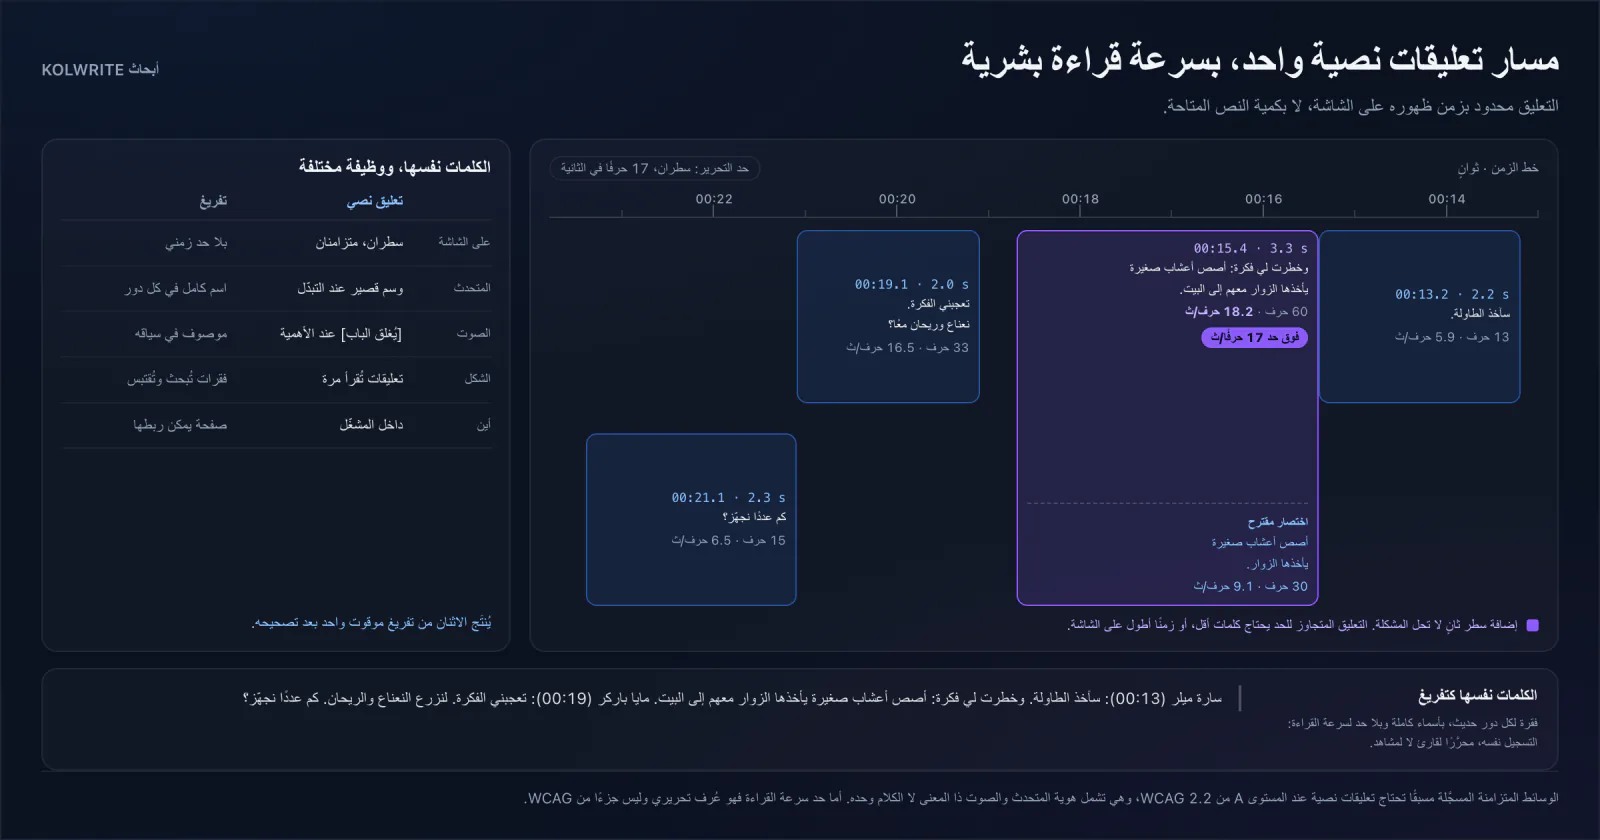
وتتعارض هذه المراحل أحياناً. قد تكون الكلمات صحيحة واسم المتحدث خاطئاً. وقد تُقرأ الجملة جيداً بينما يبقى تعليقها على الشاشة نصف ثانية. وقد يبدو الملخص مرتباً واسم العائلة داخل النص مشوّهاً. نفضّل عرض المصدر الموقوت وترك القرار للمراجع، بدل طباعة درجة ثقة فوقه.
5. ما نتحقق منه قبل الاعتماد على سير عمل
اختبر بأصعب موادك أنت. اجتماع عبر الإنترنت يتحدث فيه ثلاثة معاً، ومحاضرة سُجلت من آخر القاعة، ورسالة صوتية من ممر مزدحم، واسم عائلة يتكرر أربعين مرة. ثم قِس الوقت اللازم للوصول إلى ملف مصحَّح ترسله فعلاً، لا الوقت حتى ظهور أول نص.
يجمع KolWrite التشغيل والكلمات والمتحدثين وأزمنتها في مساحة واحدة، وينقل هذا البناء إلى المستندات وملفات التعليقات. وهذا لا يلغي عدم اليقين في التعرّف على الكلام. لكنه يجعل المواضع غير المؤكدة سهلة الاكتشاف وسريعة التصحيح. ويبقى هذا الجزء من العمل بشرياً.
أسئلة شائعة
هل التفريغ الآلي هو التعرّف على الكلام نفسه؟
التعرّف على الكلام هو الخطوة التي تحوّل الصوت إلى كلمات. أما منتج التفريغ فيضيف كشف اللغة وتمييز المتحدثين والتوقيت والترقيم والتحرير والبحث والتخزين والتصدير. ويأتي معظم الإزعاج اليومي من هذا الغلاف لا من المحرك.
لماذا يبدو النص الخاطئ سليماً عند القراءة؟
يختار فك الترميز تسلسلاً محتملاً بحسب السياق. وحين يكون الصوت غامضاً تتفوق العبارة المحتملة على العبارة المنطوقة، ويظل النص سلساً. راجع الأسماء والأرقام وكل جملة تنوي اقتباسها أمام التسجيل.
هل دعم لغات أكثر يعني جودة متساوية فيها كلها؟
لا. تختلف ساعات التدريب وتنوع اللهجات وجودة التقييم اختلافاً كبيراً بين اللغات. قائمة اللغات إعلان قدرة، وليست ادعاء دقة في لغتك.
هل تأتي أزمنة الكلمات من النموذج الذي ينتج النص نفسه؟
ليس دائماً. غالباً ما ينتج التوقيت وأسماء المتحدثين والترقيم في مراحل منفصلة. لذلك قد يحمل النص الكلمات الصحيحة في اللحظة الخاطئة. نتحقق من كل عنصر منها على حدة.
المصادر وقراءات إضافية
الأبحاث والمعايير الأصلية التي استند إليها المقال. تفتح الروابط المنشور الأصلي.
- 1 Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 2 Pratap et al., Scaling Speech Technology to 1,000+ Languages
- 3 Zhang et al., Google USM: Scaling Automatic Speech Recognition Beyond 100 Languages
- 4 Chi & Bell, Improving Code-switched ASR with Linguistic Information
- 5 Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 6 Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition