الخلاصة السريعة
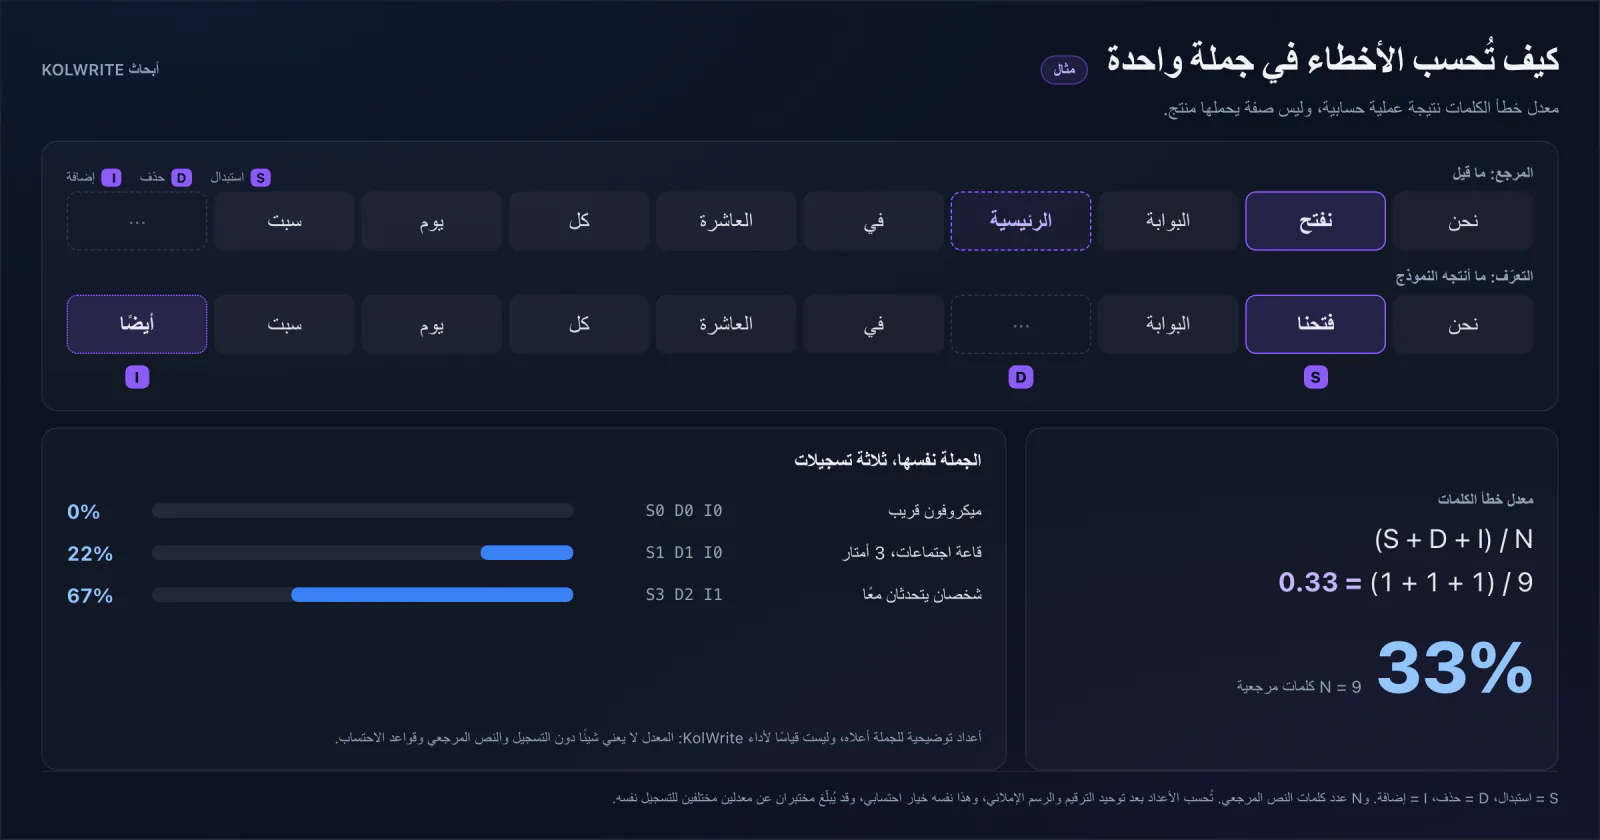
- يعدّ معدل خطأ الكلمات الاستبدال والحذف والإضافة مقابل نص مرجعي كتبه إنسان.
- يكفي تغيير قواعد التوحيد أو الإملاء أو ملفات الاختبار لينال النظام نفسه درجة مختلفة.
- يحتاج إسناد المتحدث والتوقيت والمقاطع الضائعة والأسماء وجودة التصدير إلى فحص مستقل.
- المقياس الذي يفيدك مجموعة ثابتة من تسجيلاتك أنت، تُقيَّم بالطريقة نفسها في كل مرة.
- لا ننشر رقم دقة واحداً لـ KolWrite، لأن رقماً كهذا لا يصمد أمام تسجيلاتك أنت.
1. ماذا يعدّ معدل خطأ الكلمات
يقارن معدل خطأ الكلمات، ويختصر إلى WER، مخرجات الآلة بنص مرجعي كتبه إنسان، ويعدّ ثلاثة أنواع من الخطأ: كلمة خاطئة، وكلمة ناقصة، وكلمة زائدة. ثم يُقسم المجموع على عدد كلمات المرجع. وتصدر برامج التقييم في NIST أدوات تسجيل موحّدة مع خططها، لأن المقياس البسيط نفسه يعتمد على طريقة إعداد النصين ومطابقتهما.1
يستحق المقياس مكانه في تجربة مضبوطة: الصوت نفسه، والمرجع نفسه، والقواعد نفسها على الجانبين. ويفقد معناه حين يحذف نظام كلمات الحشو ويبقيها آخر، أو حين يكتب مرجع اسماً أجنبياً بحروف لاتينية وينقله مرجع آخر صوتياً. الرقم لا يكذب. لكنه يجيب عن سؤال آخر.
2. مجموعة الاختبار تحرّك الدرجة أكثر من النموذج
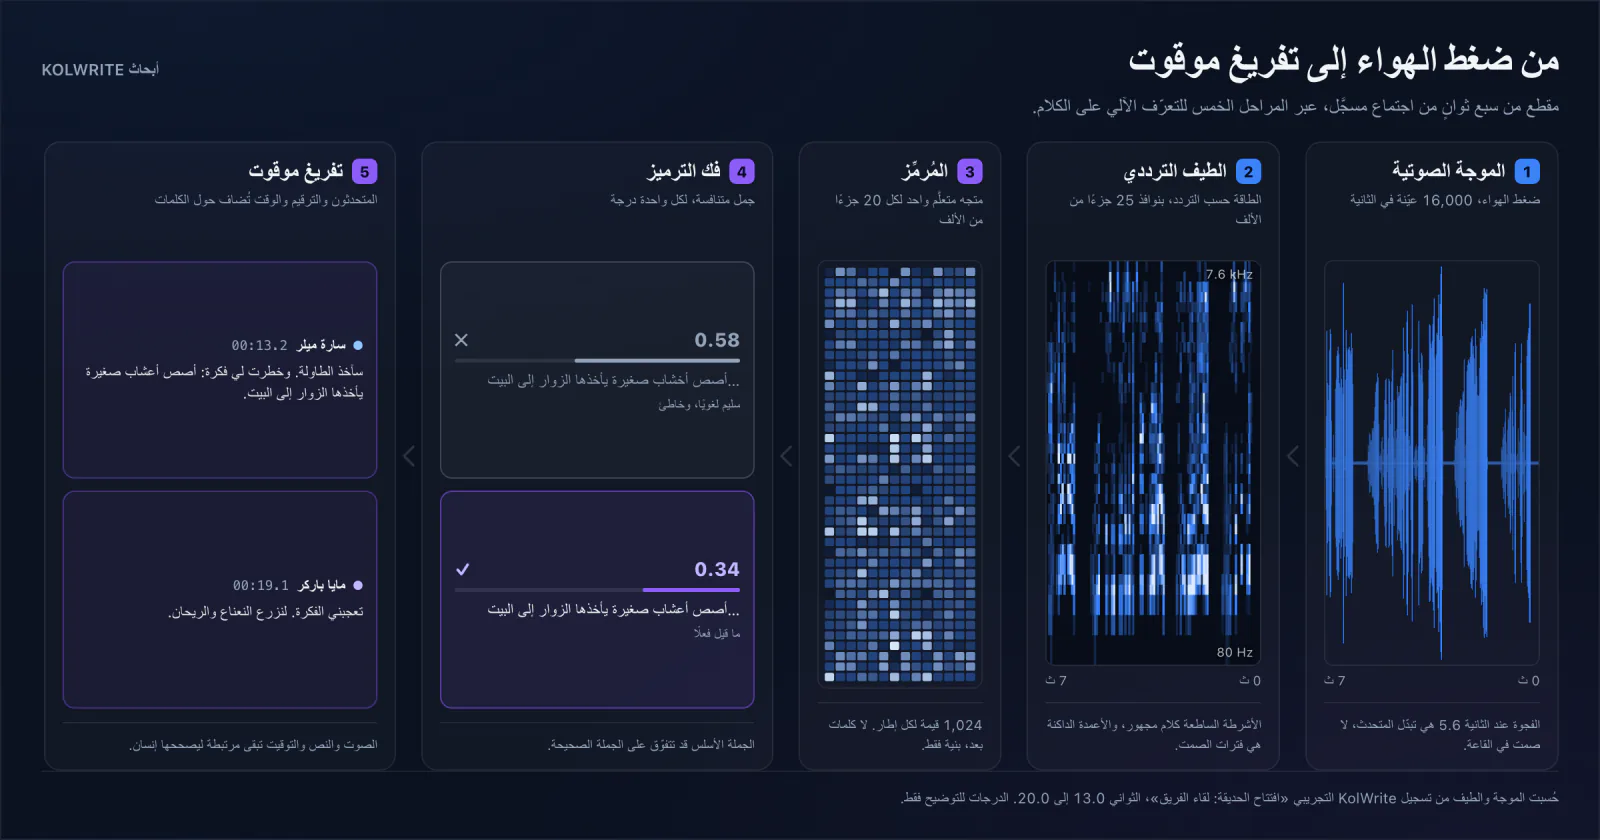
الكلام المقروء أمام ميكروفون جيد ليس بديلاً عن مكالمة دعم أو قاعة محاضرات أو أربعة أشخاص حول حاسوب محمول. ونشرت ورقة 2022 عن التدريب بإشراف ضعيف نتائجها حسب كل مجموعة بيانات وكل لغة، لا رقماً واحداً في العنوان. وهذه هي الطريقة الأمينة في النشر.2
تتفكك المقارنة المتعجلة أسرع في العبرية والعربية. فالإملاء يحدد ما يُحسب كلمة واحدة. واللهجة والانتقال بين اللغات ونسبة الكلام العفوي تغيّر صعوبة الملف. وقد بُنيت مجموعة بيانات عبرية نُشرت عام 2024 لإضافة كلام طبيعي غير مقروء إلى رصيد شحيح، وتعامل أبحاث العربية الكلام المختلط واللهجي بوصفه مشكلة قائمة بذاتها.345
3. ما يخفيه رقم واحد
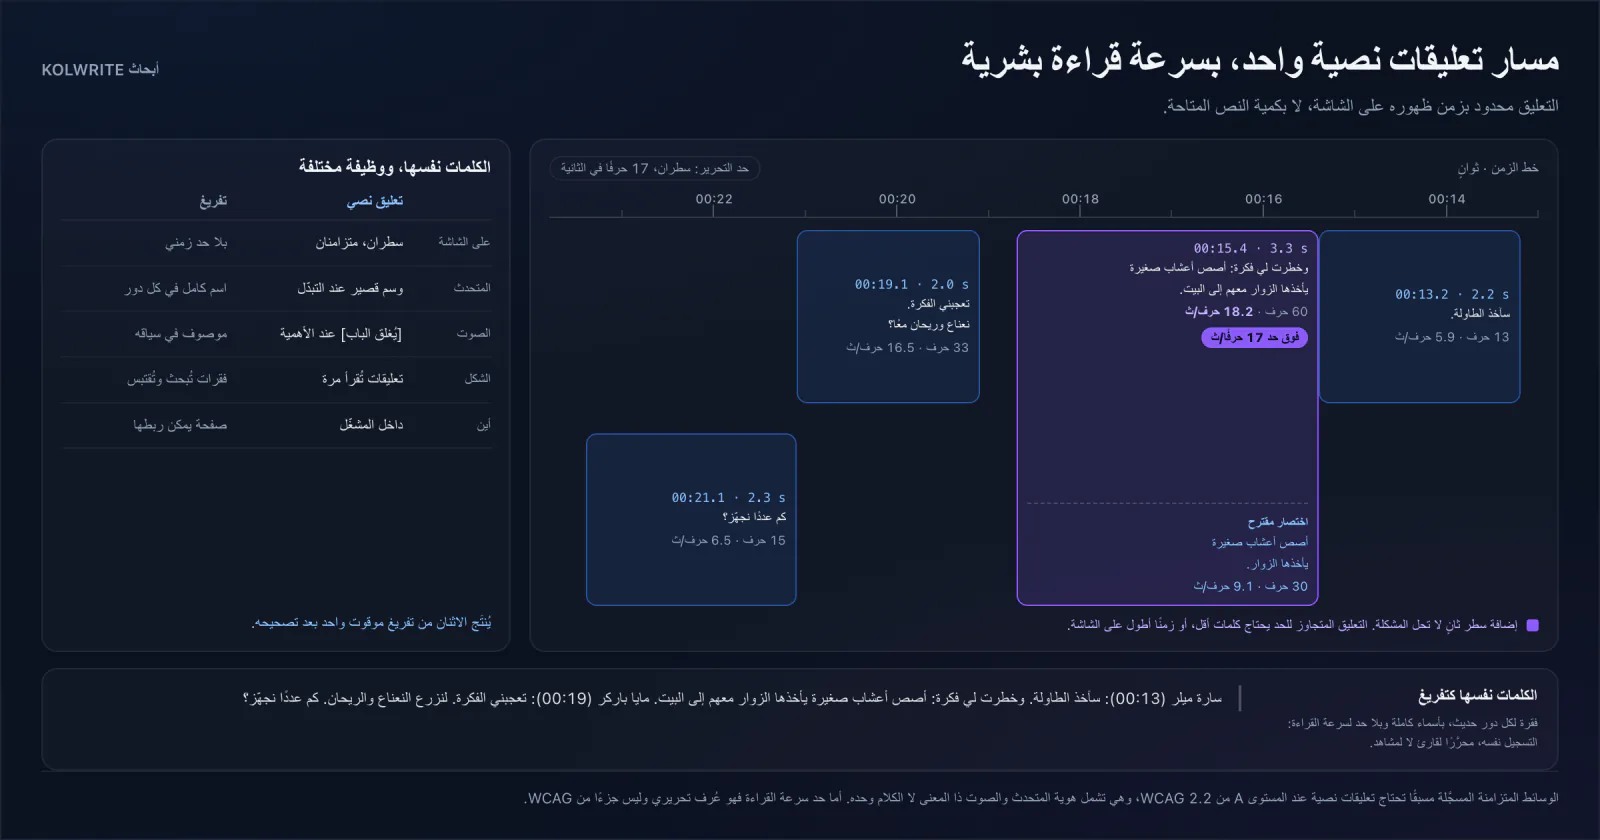
لا يقول الرقم إن كانت الكلمات الصحيحة قد نُسبت إلى المتحدث الصحيح. ولا يذكر انزياح التوقيت، ولا دقيقة اختفت بعد محاولة إرسال فاشلة، ولا سطر تعليق أطول من أن يُقرأ قبل اختفائه. ويفرض العقوبة نفسها على أداة تعريف ناقصة وعلى جرعة دواء مستبدلة.
نتابع ستة أمور بدل واحد: الصوت الناقص، والكلمات، وإسناد المتحدث، والأسماء والأرقام، والتوقيت، والدقائق التي ينفقها إنسان في التصحيح. ونضيف أمانة التصدير حين يكون الناتج مستنداً أو ملف تعليقات. هكذا تتحول الدقة من صفة إلى فحص يمكن تكراره.
4. مقياس يستطيع فريق صغير إجراءه بنزاهة
جمّد مجموعة تسجيلات تشبه عملك الحقيقي: نظيفة وصاخبة، قصيرة وطويلة، بمتحدث واحد وبخمسة، وبخلائط اللغات التي يتكلمها فريقك فعلاً. واحتفظ بالملفات الأصلية والنص المرجعي والإعدادات وتاريخ كل تشغيل. والمجموعة التي تُستبدل بهدوء بملفات أسهل لم تعد تقيس شيئاً.
أخفِ اسم المنتج عن المراجع حين تستطيع. وعُدّ الإخفاقات قبل أن يرتب أحد النص. وسجّل درجة الآلة ودقائق الإنسان جنباً إلى جنب. وأعد التشغيل بعد كل تغيير في النموذج أو في سلسلة المعالجة، وأبقِ الملفات الصعبة في المجموعة حتى حين تكون محرجة.
5. كيف يبدو ادعاء دقة أمين
الادعاء القابل للاستعمال يذكر اللغة والمجال ومجموعة البيانات وظروف التسجيل والمقياس وقواعد التوحيد وعدد الملفات وإصدار المنتج والتاريخ. ويذكر أيضاً ما لم يُقَس. ومن دون ذلك تبقى النسبة شعاراً.
لم ننشر رقم دقة لـ KolWrite، ولن نخترع رقماً من أجل صفحة كهذه. والمقارنة التي نقترحها أقل إثارة وأكثر فائدة. مرّر التسجيلات الصعبة نفسها في كل أداة، وراجع الأسماء والمتحدثين أمام الصوت، وأكمل التصدير الذي سترسله فعلاً، ثم عُدّ ما تبقى من عمل.
أسئلة شائعة
ماذا تعني عبارة دقة 99 بالمئة؟
وحدها لا تعني شيئاً تقريباً. قد تعني خطأً واحداً في كل مئة كلمة مرجعية وفق قواعد توحيد معينة، وعلى ملفات اختارها البائع. اسأل عن التسجيلات والمقياس والقواعد وتاريخ القياس. وإذا غابت هذه الإجابات فالرقم دعاية.
هل تحصل أداتان على درجتين مختلفتين للصوت نفسه؟
نعم بسهولة. فاختلاف النص المرجعي ومعالجة الترقيم والأرقام وكلمات الحشو والإملاء كلها تحرّك النتيجة. والمقارنة العادلة تثبّت هذه الخيارات قبل بدء التقييم.
ماذا نقيس إلى جانب معدل خطأ الكلمات؟
المقاطع الضائعة، وإسناد المتحدث، والأسماء والأرقام، وتوقيت الكلمات أو المقاطع، وتنسيق التعليقات، وأمانة التصدير، ونسبة المهام التي تفشل تماماً، والزمن البشري حتى الملف النهائي.
هل يكفي مقياس عام لاختيار أداة؟
هو نقطة بداية. نادراً ما تضم المجموعات العامة غرفك ولهجات فريقك ومفرداتك. ونفضّل عشرة تسجيلات من عندك قُيّمت بالطريقة نفسها على جدول ترتيب مبني على صوت غيرك.
المصادر وقراءات إضافية
الأبحاث والمعايير الأصلية التي استند إليها المقال. تفتح الروابط المنشور الأصلي.
- 1 NIST, Open Speech Analytic Technologies Pilot Evaluation Plan
- 2 Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 3 Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 4 Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition
- 5 Chi & Bell, Improving Code-switched ASR with Linguistic Information