בקיצור
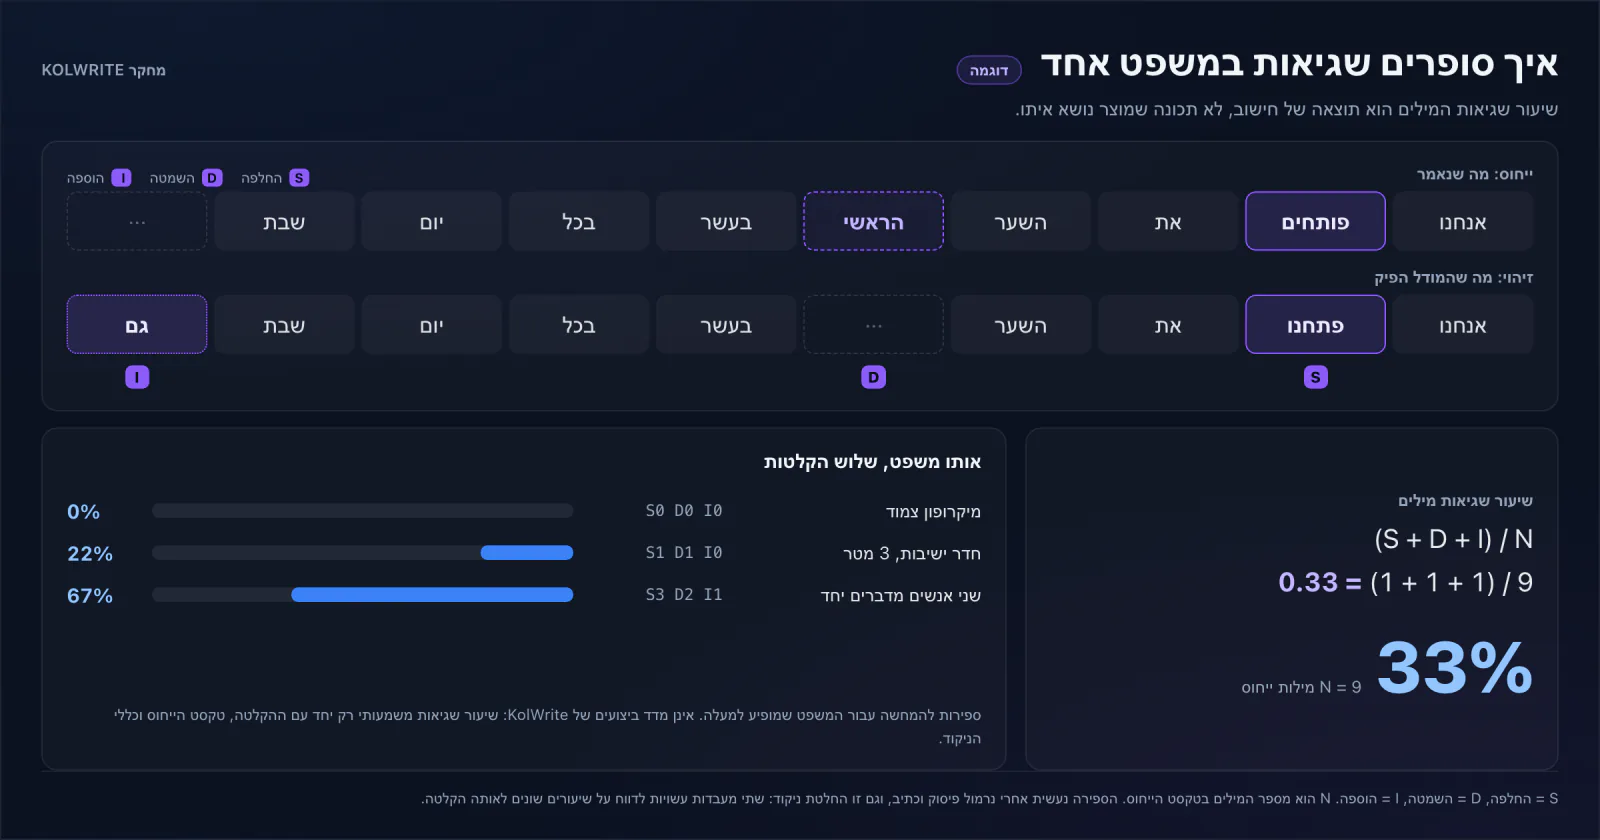
- שיעור שגיאות המילים סופר החלפות, השמטות ותוספות מול תמלול ייחוס שאדם כתב.
- שינוי בכללי הנרמול, בכתיב או בקובצי הבדיקה נותן לאותה מערכת עצמה ציון אחר.
- שיוך דוברים, חותמות זמן, קטעים שנעלמו, שמות ואיכות הייצוא דורשים בדיקה נפרדת.
- המדד שבאמת עוזר לכם הוא סט קבוע של ההקלטות שלכם, שנבדק כל פעם באותה שיטה.
- אנחנו לא מפרסמים מספר דיוק אחד ל־KolWrite, כי מספר כזה לא שורד את המפגש עם האודיו שלכם.
1. מה שיעור שגיאות המילים סופר
שיעור שגיאות המילים, שמסומן WER, מיישר את פלט המכונה מול תמלול ייחוס שאדם כתב וסופר שלושה סוגי טעות: מילה שגויה, מילה חסרה ומילה שנוספה. הסכום מחולק במספר המילים בתמלול הייחוס. תוכניות ההערכה של NIST מגיעות עם כלי ניקוד אחידים, כי גם מדד פשוט תלוי באופן שבו מכינים את שני הטקסטים ומתאימים ביניהם.1
במעבדה המדד הזה שווה זהב. אותו אודיו, אותו תמלול ייחוס, אותם כללים לשני הצדדים. הוא מאבד משמעות כשמערכת אחת מוחקת מילות מילוי והשנייה שומרת אותן, או כשתמלול ייחוס אחד כותב שם לועזי באותיות לטיניות והשני מתעתק אותו לעברית. המספר לא משקר. הוא פשוט עונה על שאלה אחרת.
2. סט הבדיקה מזיז את הציון יותר מהמודל
דיבור מוקרא מול מיקרופון טוב הוא לא תחליף לשיחת שירות, לשיעור באוניברסיטה או לארבעה אנשים סביב מחשב נייד. המאמר מ־2022 על אימון בפיקוח חלש פרסם תוצאות לפי מאגר ולפי שפה, ולא מספר כותרת אחד. זו הדרך ההוגנת לדווח.2
בעברית ובערבית השוואה מרושלת מתפרקת מהר יותר. הכתיב קובע מה נחשב מילה אחת. הלהג, המעבר בין שפות וכמות הדיבור הספונטני בקובץ משנים את רמת הקושי. מאגר עברי שפורסם ב־2024 נבנה בין השאר כדי להוסיף דיבור טבעי ולא מוקרא למאגר דל, ומחקרי ערבית מתייחסים לדיבור מעורב ולדיבור בלהג כבעיה בפני עצמה.345
3. מה ציון אחד מסתיר
הציון לא אומר אם המילים הנכונות הודבקו לדובר הנכון. הוא לא מספר על חותמות זמן שזוחלות, על דקה שנעלמה אחרי ניסיון שליחה כושל, או על שורת כתובית ארוכה מכדי להספיק לקרוא אותה. הוא גם גובה אותו מחיר על מילית שנשמטה ועל מינון תרופה שהוחלף.
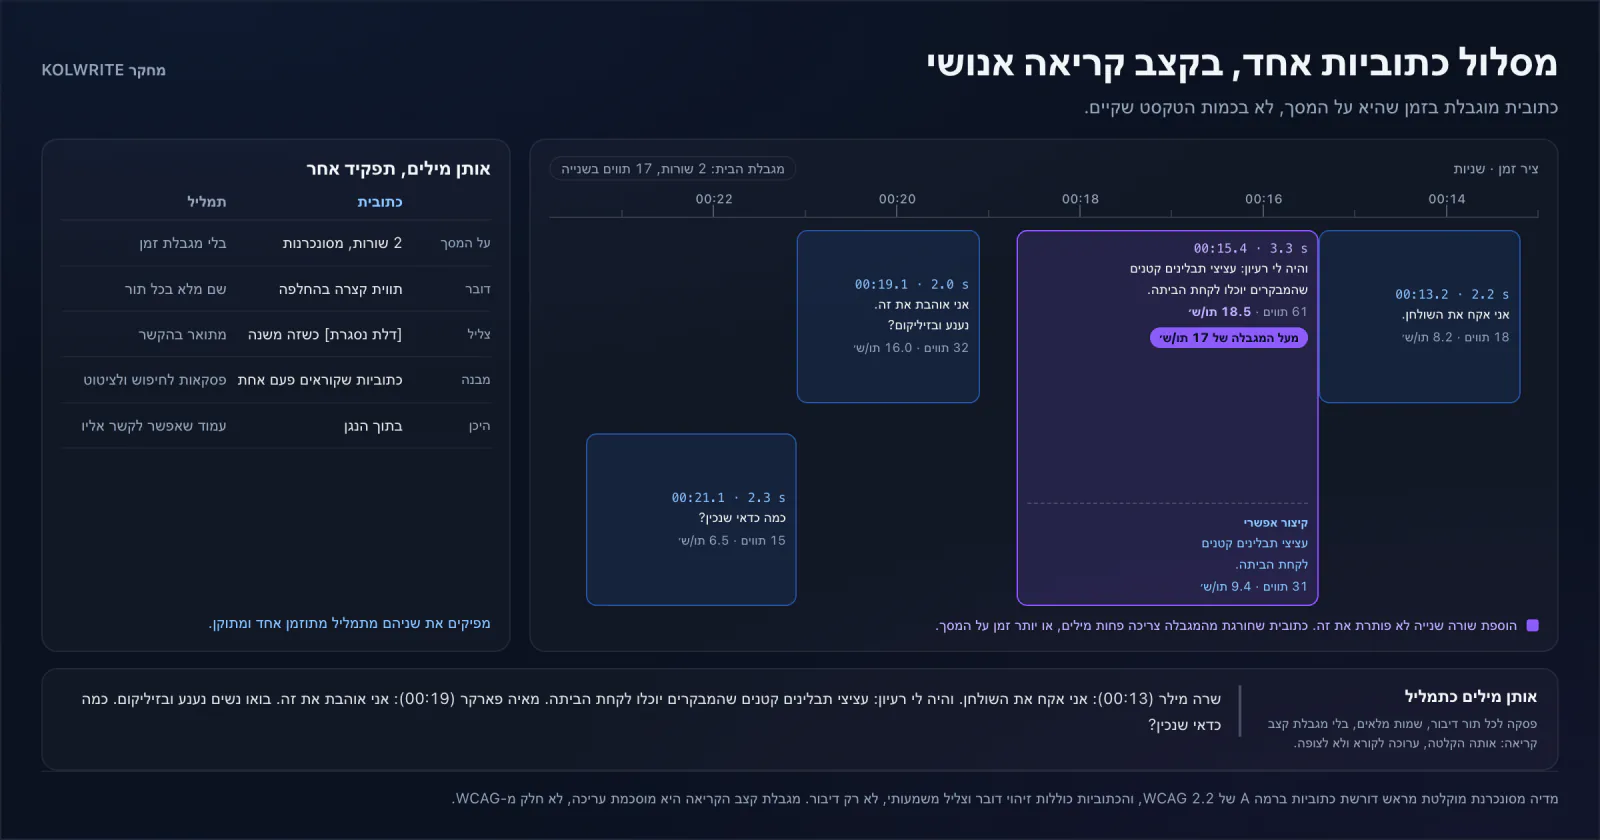
אנחנו עוקבים אחרי שישה דברים במקום אחד: אודיו חסר, מילים, שיוך דוברים, שמות ומספרים, תזמון, והדקות שאדם משקיע בתיקון. כשהתוצר הוא מסמך או קובץ כתוביות מוסיפים גם את נאמנות הייצוא. ככה דיוק מפסיק להיות שם תואר והופך לבדיקה שאפשר לחזור עליה.
4. מדד שצוות קטן יכול להריץ ביושר
הקפיאו סט הקלטות שנראה כמו העבודה האמיתית שלכם: נקי ורועש, קצר וארוך, דובר אחד וחמישה, ותערובות השפות שהאנשים שלכם באמת מדברים. שמרו את הקבצים המקוריים, את תמלול הייחוס, את ההגדרות ואת התאריך של כל הרצה. סט שמחליפים בשקט בקבצים קלים יותר כבר לא מודד כלום.
הסתירו מהבודק את שם המוצר כשאפשר. ספרו את הכשלים לפני שמישהו מסדר את הטקסט. רשמו את ציון המכונה ואת דקות האדם זה לצד זה. הריצו שוב אחרי כל שינוי במודל או בשרשרת העיבוד, והשאירו בסט את הקבצים הקשים גם כשהם מביכים.
5. איך נראית טענת דיוק הגונה
טענה שאפשר לעשות איתה משהו מציינת את השפה, התחום, המאגר, תנאי ההקלטה, המדד, כללי הנרמול, מספר הקבצים, גרסת המוצר והתאריך. היא גם אומרת מה לא נמדד. בלי זה, אחוז הוא סיסמה.
לא פרסמנו מספר דיוק ל־KolWrite, ולא נמציא אחד בשביל עמוד כזה. ההשוואה שאנחנו ממליצים עליה משעממת ומועילה יותר. העבירו את אותן הקלטות קשות בכל כלי, בדקו שמות ודוברים מול ההקלטה, סיימו את הייצוא שהייתם באמת שולחים, וספרו כמה עבודה נשארה.
שאלות שחוזרות
מה אומר 99 אחוז דיוק?
לבד, כמעט כלום. ייתכן שמדובר בשגיאה אחת למאה מילים לפי כללי נרמול מסוימים, על קבצים שהמוכר בחר. שאלו אילו הקלטות, איזה מדד, אילו כללים ומתי נמדד. אם התשובות חסרות, זו פרסומת.
שני כלים יכולים לקבל ציונים שונים על אותו אודיו?
בקלות. תמלולי ייחוס שונים, יחס שונה לפיסוק, למספרים, למילות מילוי ולכתיב מלא או חסר, כל אלה מזיזים את התוצאה. השוואה הוגנת קובעת את הכללים לפני הניקוד.
מה עוד למדוד חוץ משיעור שגיאות המילים?
קטעים שנעלמו, שיוך דוברים, שמות ומספרים, תזמון מילים או מקטעים, פריסת כתוביות, נאמנות ייצוא, שיעור ההרצות שנכשלות, והזמן האנושי עד לקובץ מוגמר.
אפשר לבחור כלי לפי מדד ציבורי?
זו נקודת פתיחה. מאגרים ציבוריים כמעט אף פעם לא מכילים את החדרים שלכם, את המבטאים שלכם ואת אוצר המילים שלכם. אנחנו מעדיפים עשר הקלטות שלכם שנבדקו באותה שיטה על פני טבלת דירוג שנבנתה על אודיו של מישהו אחר.
מקורות וקריאה נוספת
המחקרים והתקנים שעליהם נשען המאמר. כל קישור מוביל לפרסום המקורי.
- 1 NIST, Open Speech Analytic Technologies Pilot Evaluation Plan
- 2 Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 3 Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 4 Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition
- 5 Chi & Bell, Improving Code-switched ASR with Linguistic Information