בקיצור
- זיהוי דיבור מנבא את הטקסט הסביר ביותר לקטע אודיו. אין בהקלטה תסריט נסתר שהמערכת שולפת.
- אימון על כמויות ענק של אודיו רב־לשוני שיפר את היציבות. רשימת שפות נתמכות עדיין לא מבטיחה איכות דומה בכל אחת מהן.
- הפרדת דוברים, חותמות זמן, פיסוק וייצוא הם רכיבים נפרדים סביב מנוע הזיהוי. כל אחד מהם נשבר לחוד.
- המיקרופון והחדר קובעים בדרך כלל יותר מהשאלה באיזה מודל בחרתם.
- אנחנו מחזיקים את האודיו, את הטקסט המתוזמן ואת התיקון האנושי במקום אחד, כי שם הטעויות מתגלות.
1. מה שהתוכנה מקבלת הוא אות, לא משפט
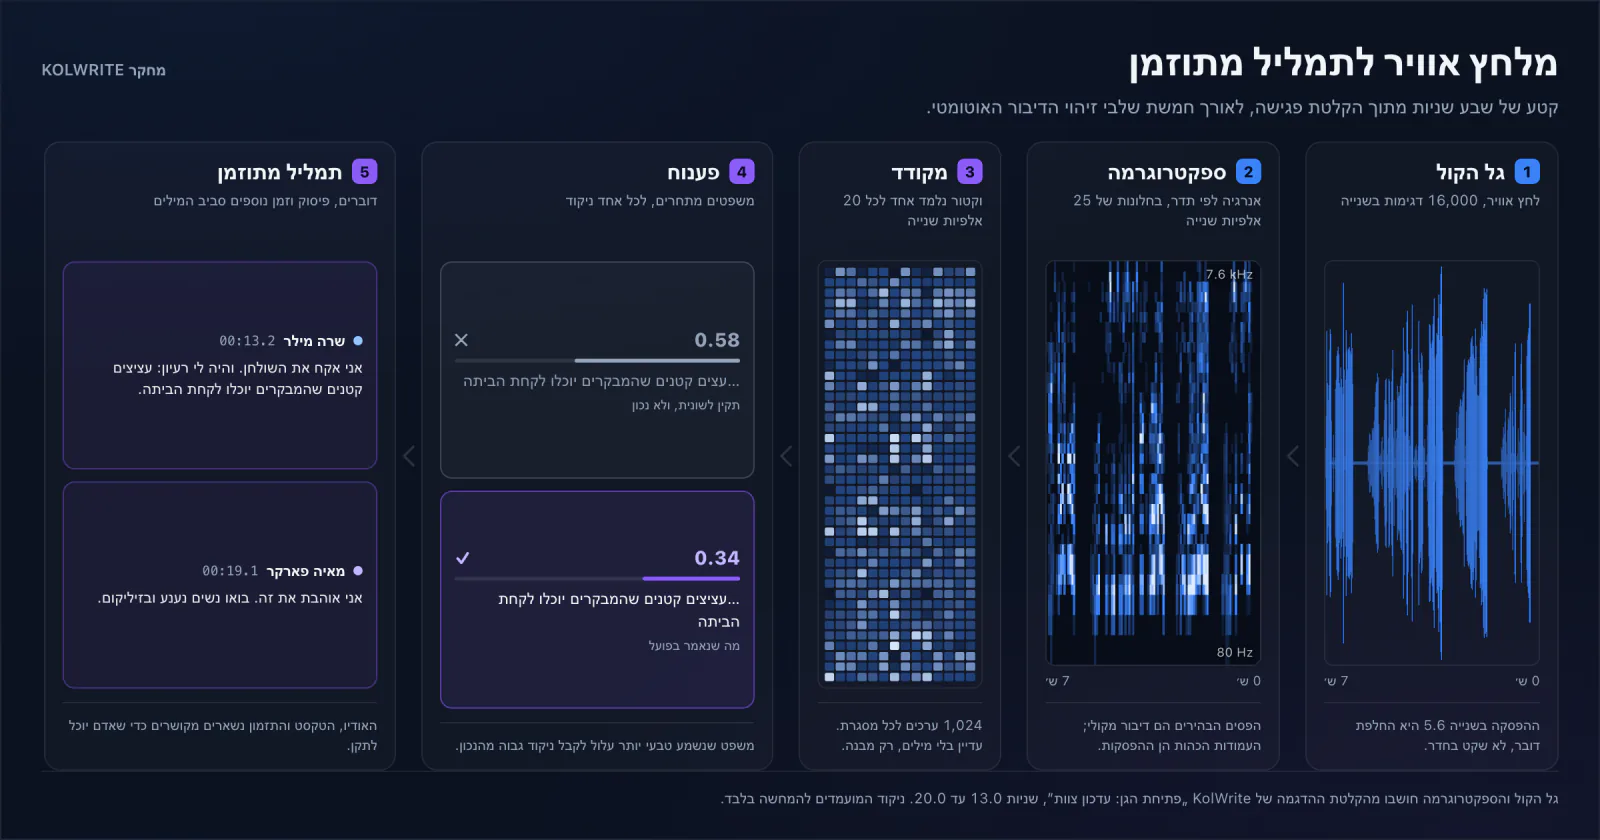
הקלטה מגיעה לתוכנה כרשימה ארוכה של מספרים. כל מספר הוא לחץ האוויר ברגע אחד. לפני שמציעים מילה אחת, חותכים את האודיו לחלונות קצרים, ומתארים בכל חלון איך האנרגיה מתחלקת בין התדרים. מודלים חדשים לומדים חלק גדול מהתיאור הזה בעצמם. הפיזיקה לא משתנה. שני דוברים, הד של חדר, מאוורר של מחשב ודחיסה של קובץ מגיעים כולם באותו אות.
לכן המיקרופון חשוב יותר משנדמה. מיקרופון צמוד לפה שומר עיצורים ואת הרווחים הקטנים בין מילים. טלפון שמונח באמצע שולחן בישיבת הנהלה אוסף את ההד ואת כולם יחד. עוד לא ראינו מודל שפה שמחזיר עיצור שהחדר בלע.
2. המקודד בונה מפה של דיבור
המקודד הופך מקטעי אודיו קצרים לווקטורים. הווקטורים נושאים את מה שעוזר לניבוי: פרטים פונטיים, קצב, והבחנה חלקית בין קול, רעש ושקט. קפיצת המדרגה הגיעה מאימון מקדים בהיקף עצום. מאמר מ־2022 דיווח על אימון על 680 אלף שעות אודיו רב־לשוני בפיקוח חלש. עבודות מאוחרות יותר הרחיבו את הכיסוי למעל מאה שפות, ואחר כך למעל אלף, בעיקר בעזרת הקלטות שאיש לא תימלל.123
היקף קונה חשיפה, לא שוויון. מודל שפגש יותר מיקרופונים, מבטאים ונושאים מופתע פחות מההקלטה שלכם. רשימת שפות אומרת שתקבלו טקסט בשפה הזאת. היא לא אומרת איך המערכת תתמודד עם שיחת מכירה בעברית, עם ריאיון בערבית פלסטינית או עם משפט שמתחיל בעברית ונגמר באנגלית.
3. הפענוח הוא תחרות בין משפטים סבירים
המערכת לא בוחרת מילה אחת בכל צעד. היא מדרגת רצפים שלמים מול האודיו ומול מה שלמדה על הדרך שבה משפטים נבנים. בזכות זה היא מעדיפה צירוף הגיוני על פני רצף צלילים דומים. מאותה סיבה בדיוק היא גם מסוגלת להחזיר משפט רהוט שאיש לא אמר, כשהאודיו עכור.
שמות, מספרים ומעבר בין שפות הם המקום שבו זה מתגלה. מחקרים על זיהוי דיבור מעורב חוזרים על אותו מחסור: יש הרבה אודיו בכל שפה בנפרד, ומעט מאוד אודיו שבו דובר מחליף שפה באמצע משפט. לעברית ולערבית יש קשיים משלהן, בהם כתיב לא יציב ומעט דיבור ספונטני מוקלט. מאגרי מחקר חדשים מרחיבים את ההיצע הזה. הם לא סוגרים את הפער.456
4. תמלול מוגמר הוא שרשרת שלבים, לא תשובה אחת
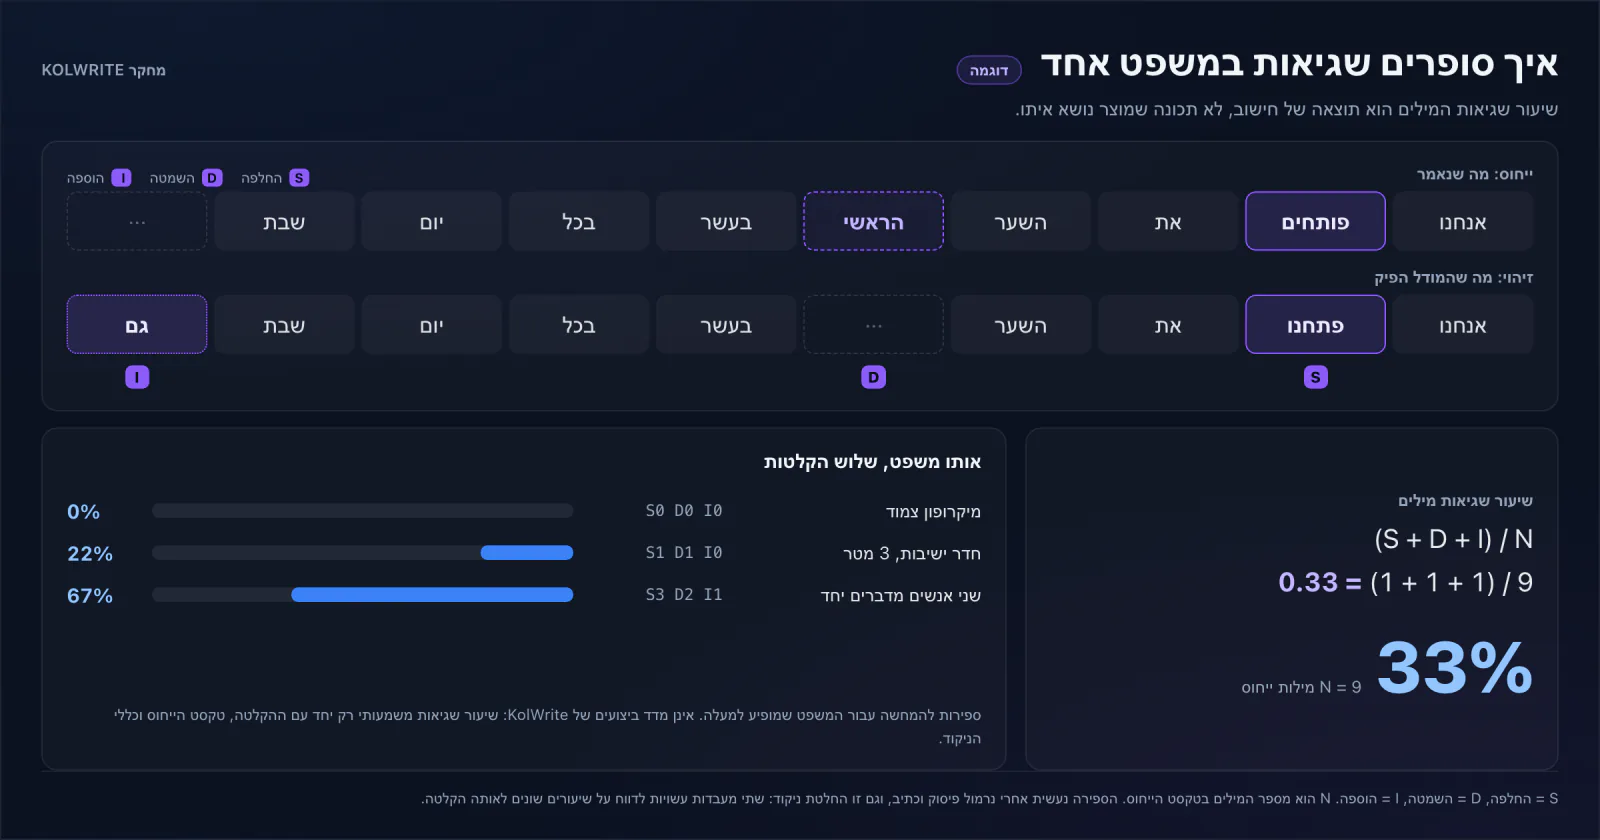
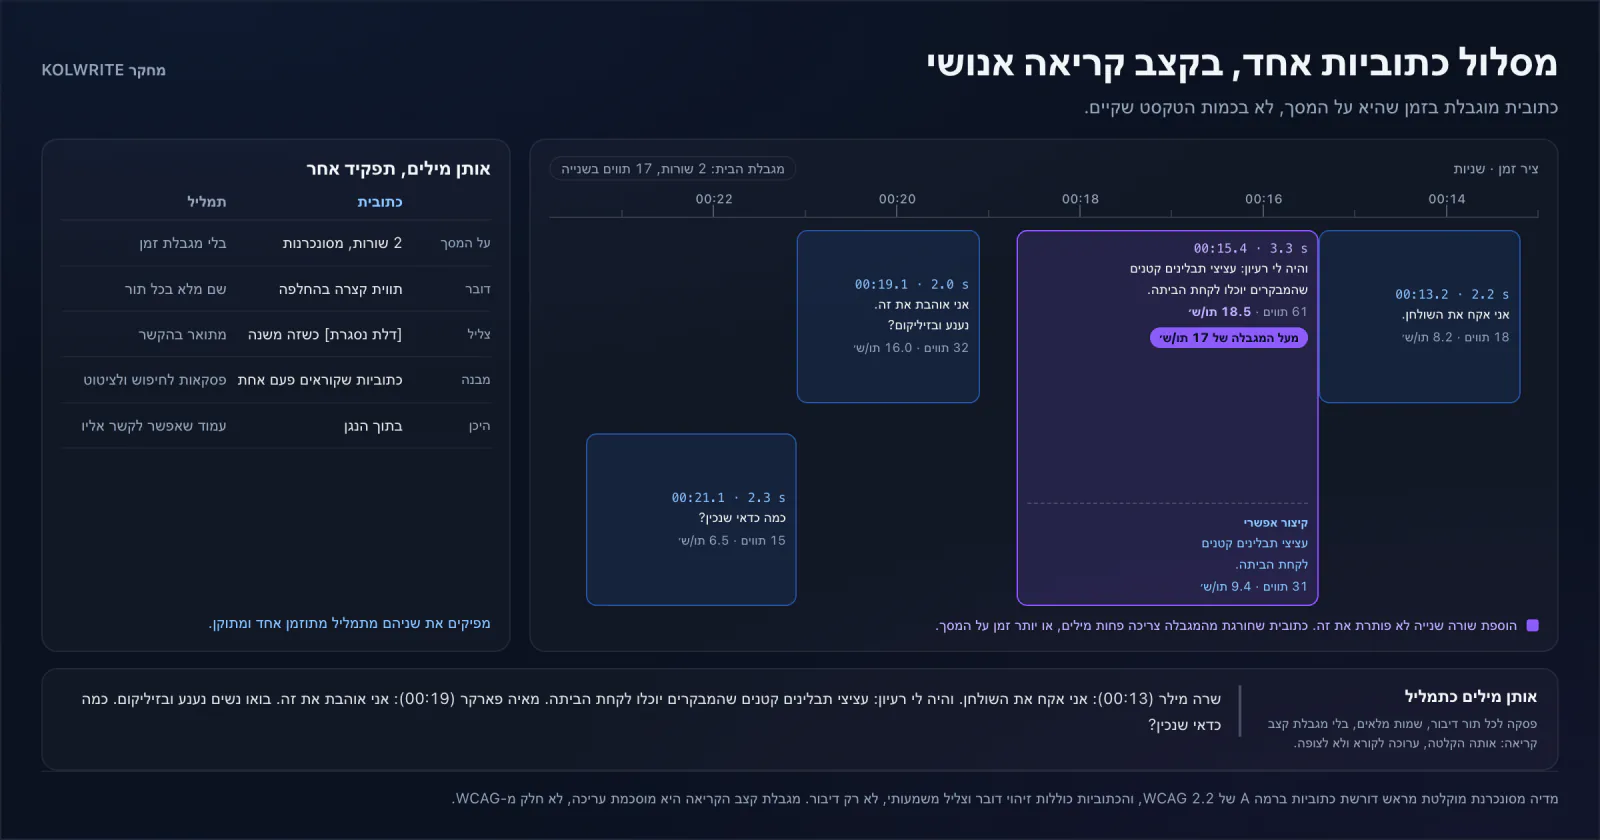
מנוע הזיהוי מפיק מילים וזמנים. הפרדת דוברים עונה על שאלה אחרת: מי דיבר ומתי. יישור מחזיר כל מילה לשעון. פיסוק וחלוקה לפסקאות הופכים את הטקסט לקריא. אחר כך מגיעים אחסון, ניסיונות חוזרים, עריכה, חיפוש וייצוא. כל שלב הוא רכיב בפני עצמו, וכל אחד מהם יכול להיכשל לבד.
השלבים גם סותרים זה את זה. המילים יכולות להיות נכונות בזמן שתווית הדובר שגויה. משפט יכול להיקרא יפה בזמן שהכתובית שלו נשארת על המסך חצי שנייה. סיכום יכול להיראות מסודר בזמן ששם משפחה בתוך התמלול מעוות. אנחנו מעדיפים להראות את המקור המתוזמן ולתת לאדם להכריע, במקום להדפיס מעליו ציון ביטחון.
5. מה אנחנו בודקים לפני שסומכים על תהליך
בדקו עם החומר הקשה שלכם. ישיבת הנהלה בזום ששלושה אנשים מדברים בה יחד, שיעור באוניברסיטה שהוקלט מהשורה האחרונה, הודעה קולית בוואטסאפ ממסדרון סואן, ושם משפחה שחוזר ארבעים פעם. אחר כך מדדו כמה זמן לוקח להגיע לקובץ מתוקן שהייתם באמת שולחים, ולא כמה זמן עובר עד שמופיע הטקסט הראשון.
KolWrite מחזיקה את ההשמעה, המילים, הדוברים וחותמות הזמן במקום אחד, ומעבירה את המבנה הזה למסמכים ולקובצי כתוביות. זה לא מוריד את אי־הוודאות מזיהוי הדיבור. זה הופך את החלקים הלא ודאיים לקלים לאיתור ומהירים לתיקון. החלק הזה בעבודה עדיין שייך לאדם.
שאלות שחוזרות
תמלול AI וזיהוי דיבור זה אותו דבר?
זיהוי דיבור הוא השלב שהופך אודיו למילים. מוצר תמלול עוטף אותו בזיהוי שפה, הפרדת דוברים, תזמון, פיסוק, עריכה, חיפוש, אחסון וייצוא. רוב התסכול היומיומי מגיע מהעטיפה, לא מהליבה.
למה תמלול שגוי נקרא כל כך טוב?
המפענח בוחר רצף מילים סביר לפי ההקשר. כשהאודיו לא ברור, צירוף סביר מנצח את מה שבאמת נאמר, והתוצאה עדיין רהוטה. בדקו מול ההקלטה שמות, מספרים וכל משפט שאתם מתכוונים לצטט.
אם המערכת תומכת ביותר שפות, היא טובה באותה מידה בכולן?
לא. שעות האימון, מגוון הלהגים ואיכות הבדיקה שונים מאוד בין שפות. רשימת שפות היא הצהרת יכולת. היא לא טענה על דיוק בשפה שלכם.
חותמות הזמן מגיעות מאותו מודל שמייצר את המילים?
לא תמיד. תזמון, תוויות דובר ופיסוק מיוצרים לא פעם בשלבים נפרדים. ככה תמלול מקבל את המילים הנכונות ברגע הלא נכון. אנחנו בודקים כל אחד מהם בנפרד.
מקורות וקריאה נוספת
המחקרים והתקנים שעליהם נשען המאמר. כל קישור מוביל לפרסום המקורי.
- 1 Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 2 Pratap et al., Scaling Speech Technology to 1,000+ Languages
- 3 Zhang et al., Google USM: Scaling Automatic Speech Recognition Beyond 100 Languages
- 4 Chi & Bell, Improving Code-switched ASR with Linguistic Information
- 5 Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 6 Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition